
Što Google ne bi smio indeksirati na vašoj web trgovini
Autorica: Biljana Jelić, vlasnica agencije Digitalni Puls. Agencija se nekoliko godina bavi SEO-om i do sada je radila s više od 40 klijenata, među njima i s web trgovinama na WooCommerceu.
Odgovor odmah, da ne morate čitati do kraja: Google ne treba vidjeti ništa što je napravljeno za jednu osobu. To su dijeljene liste želja, rezultati interne pretrage, kombinacije filtara, usporedbe proizvoda, košarica i računi kupaca. Sve to može ostati u trgovini. Samo ne smije završiti u indeksu.
Zašto vas se to tiče? Svaka takva adresa troši vrijeme koje Google ima za vašu trgovinu. U vodiču za filtrirane adrese Google sam kaže da se zabranom takvih adresa štede resursi za crawlanje. Što ga manje potroši na tuđu listu želja, to ga više ostane za proizvod koji ste jučer dodali.
Što se promijenilo 26. listopada
Google je 26. listopada 2026. dopisao novi odjeljak u dokument o sprječavanju spama korisničkog sadržaja. Zove se „Only index content meant for Search“, a znači: u indeks ide samo ono što je napravljeno da ga ljudi pronađu preko tražilice. Za stranice napravljene za izravno dijeljenje, suradnju ili praktičnu upotrebu Google preporučuje noindex ili zabranu crawlanja u robots.txt datoteci kao zadanu postavku. Noindex se postavlja robots meta oznakom ili X-Robots-Tag zaglavljem. Uz to savjetuje da u Search Consoleu redovito pratite izvješća Page indexing i Search performance, zbog neočekivanih skokova broja indeksiranih stranica.
Za pravu sliku: dokument je pisan za platforme na kojima korisnici objavljuju dijeljene stranice, generirani sadržaj ili web aplikacije. Web trgovine u njemu nema. Ali kupac koji kopira poveznicu na svoju listu želja i pošalje je prijateljici napravio je upravo to, dijeljenu stranicu. Zato je primjena na trgovine naše čitanje, a ne Googleova izjava.
Što u trgovini ne treba završiti u Googleu
Ovako to slažemo, po vrstama adrese. Zadnji stupac nije slučajan, a zašto je razlika između noindexa i robots.txt datoteke važna, objašnjavamo odmah ispod tablice.
| Vrsta stranice | Kako izgleda adresa | Što napraviti |
|---|---|---|
| Dijeljena lista želja | Adresa s jedinstvenim kodom, izgled ovisi o dodatku | noindex |
| Usporedba proizvoda | Adresa s popisom odabranih proizvoda | noindex |
| Košarica, naplata, moj račun | Adrese košarice, naplate i računa kupca | noindex |
| Rezultat konfiguratora ili kalkulatora | Generirana stranica s kupčevim izborom | noindex |
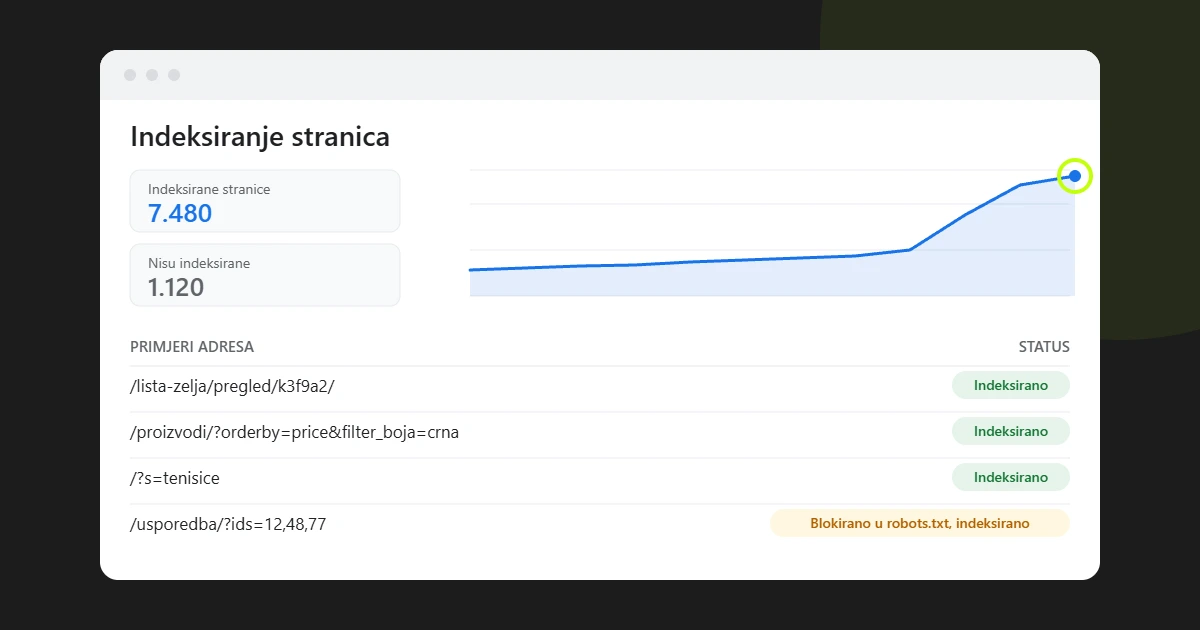
| Rezultati interne pretrage | Adresa s parametrom pretrage, na primjer ?s=tenisice | Zabrana u robots.txt datoteci |
| Filtri i sortiranje | Adrese poput ?orderby=price ili ?filter_boja=crna | Zabrana u robots.txt datoteci, osim kombinacija s pravom potražnjom |
| Kombinacije filtara bez rezultata i nepostojeće stranice paginacije | Adrese koje nikad nisu trebale postojati | HTTP odgovor 404 |
Adrese s jedinstvenim kodom koje stvara dodatak za liste želja ovise o dodatku. Neki ih označe noindexom sami, neki ne. [PROVJERITI: kako se ponašaju najčešći dodaci za liste želja na WooCommerceu, prije objave testirati barem dva.]
Noindex ili robots.txt: ne oboje na istu adresu
Ovdje se najčešće griješi. Google u dokumentu o robots meta oznaci objašnjava da robot noindex pročita tek kad otvori stranicu. Ako je adresa zabranjena u robots.txt datoteci, do oznake nikad ne dođe i ona se zanemaruje.
Zato razdvajamo dvije skupine. Adrese koje se množe bez kraja, poput pretrage, filtara i sortiranja, štitimo robots.txt datotekom, što je i Googleova preporuka u vodiču za filtrirane adrese. Pojedinačne stranice koje stvarno postoje, a ne trebaju biti u rezultatima, poput liste želja, usporedbe i košarice, dobivaju noindex i moraju ostati dostupne robotu.
Zabrana nije jamstvo. U Search Consoleu postoji status „Indexed, though blocked by robots.txt“. Znači da je adresa ušla u indeks usprkos zabrani, jer je Google za nju saznao preko poveznica s drugih stranica. Ako vam se to dogodi s adresama koje želite maknuti, treba učiniti suprotno od očekivanog: skinuti zabranu, dodati noindex i pričekati da ga Google pročita. Zabranu možete vratiti kasnije.
Na probnoj verziji jedne web stranice koju smo nedavno postavljali u robots.txt datoteci namjerno nema nijedne zabrane, a noindex dolazi iz HTTP zaglavlja. Da zabrana postoji, robot noindex ne bi mogao pročitati, a adresa bi mogla završiti u indeksu bez opisa.
Što vam je već u indeksu: provjera za deset minuta
Trebaju vam deset minuta i pristup Search Consoleu.
- U izvješću Indexing, Pages (Indeksiranje, Stranice) otvorite popis indeksiranih stranica i tablicu „Why pages aren’t indexed“. Tražite adrese s parametrima i adrese koje ne prepoznajete.
- U izvješću Performance dodajte filter Page, „URL contains“. Zatim redom upišite dio adrese koji koristi vaš dodatak za liste želja, zatim
?orderby=,?filter_i?s=. Ako vidite prikaze, Google je te adrese već pokazivao ljudima. - U alatu URL Inspection zalijepite jednu dijeljenu adresu liste želja i pogledajte kaže li alat da je adresa na Googleu.
- Usporedite broj indeksiranih stranica s brojem proizvoda i kategorija koje imate. Velika razlika gotovo uvijek znači adrese koje se množe same. [UMETNUTI: primjer iz trgovine klijenta, broj proizvoda i kategorija, broj indeksiranih adresa i razlika, uz dopuštenje klijenta.]
- Ako je broj indeksiranih stranica odjednom skočio, to je upravo znak za provjeru koji Google navodi u svom dokumentu.
Filtre s pravom potražnjom pretvorite u kategorije
Nemojte svaki filtar proglasiti smećem. Ako ljudi stvarno traže „crne ženske tenisice“, ta kombinacija zaslužuje vlastitu kategoriju s adresom, naslovom i tekstom, a ne filtriranu adresu s parametrima. Prije nego išta zabranite, u izvješću Performance pogledajte donose li te adrese klikove. Što donosi promet, ostavite i uredite. Ostalo zabranite.
Ako ne želite sami kroz izvješća
Pregled indeksa prvo je što radimo na svakoj web trgovini. Ako želite da to prođemo umjesto vas, zatražite besplatnu SEO analizu. Pogledat ćemo koje se adrese množe u vašem indeksu i poslat ćemo vam konkretne nalaze. Kako inače radimo, pročitajte na stranici SEO za WooCommerce.
Kako je članak nastao: Googleove dokumente otvorili smo i pročitali 27. listopada 2026. U tekstu je odvojeno što piše u njima, a što je naše čitanje i način rada. Činjenice iz Googleovih dokumenata navedene su u izvorima ispod.
Izvori
- Google Search Central: Prevent user-generated spam on your site and platform (zadnja izmjena 26. 10. 2026.)
- Google Search Central: Managing crawling of faceted navigation URLs
- Google Search Central: Robots meta tag, data-nosnippet i X-Robots-Tag
- Search Console Help: Page indexing report
Mi pratimo Google i zakone, a vi radite svoj posao.
Pišemo samo kad je važno, o promjenama u Googleu i propisima koje utječu na vaš posao, uz savjete i besplatne alate koje sami razvijamo.
Popis od 17 obveza koje vaša web stranica mora imati u 2026., uz svaku propis i rok.
- Samo kad je važno
- Bez spama
- Odjava jednim klikom